 Hyunae Park
약한 기준선에서 멈추지 않기
Open-loop와의 큰 차이 뒤에 같은 이득의 PD-only를 추가해 사전 토크의 기여를 따로 측정했습니다. 추가 실험의 사후 설계와 새 시드를 기록했습니다.
Physical AI · 영상 지각 + 물리 제어
영상에서 추출한 목표를 MuJoCo의 4관절 팔로 실행하고 관절 피드백으로 보정했습니다. 400개 물리 평가에서 제어 항목을 분리해 비교하고, 실제 영상의 전부 보류·사후 오거절 결과까지 공개합니다.
새 시드 20개 · 동일 PD 이득에서 사전 토크 계획 추가
원래 160 + 추가 240 · 개발 60은 별도 · 한 기준 동작
원래 8개 모두 unknown · 사후 수정도 양성 3개 전부 거절
01 / PROBLEM
V1에서는 시간 정렬 비용이 작아도 실제 춤의 순서 변경·생략·정지를 놓쳤습니다. V2는 필수 단계의 순서·유지 시간·관측 가능성을 분리하고, 영상으로 만든 목표를 물리 모형에 실행하는 별도 제어 실험을 추가했습니다.
두 질문의 결과를 섞지 않았습니다. 실제 영상의 단계 판정은 모두 보류됐고, 시뮬레이션에서는 관절 상태 피드백과 사전 토크 계획의 기여를 측정했습니다. 사람이 춤을 정확히 따라 하는지와 로봇이 목표를 추종하는지는 서로 다른 검증입니다.
02 / PERCEPTION
공개 YOLO11s Pose로 관절과 신뢰도를 추출합니다. 몸통 크기와 중심을 기준으로 좌표를 정규화하고, 기준에 정의한 필수 단계마다 유효한 관측과 유지 시간을 요구합니다. 선택된 표본을 여러 단계에 재사용하지 않으며 관측 불가 표본은 유지 시간을 끊습니다. 다만 원래 구현은 샘플링 사이의 짧은 가림, 동일한 기하 자세를 가진 다른 단계 이름, 누락된 시각과 중복 ID를 완전히 처리하지 못합니다. 이 반례는 V2 보고서의 구현 감사에 공개했습니다.
기존 V1의 21개 비교는 모두 본 개발 자료로 명시했습니다. 규칙과 임계값을 고정한 뒤, 새 실제 영상의 원본·구간·AI 보조 시각 라벨을 별도로 고정하고 추론했습니다. unknown을 실패나 성공으로 바꾸어 집계하지 않습니다.
원본과 시각 라벨 고정
관절 신뢰도·유효 관측
모든 필수 단계의 증거
pass / fail / unknown
03 / REAL-FOOTAGE EVALUATION
새 자료는 촬영 원본 2개에서 보이는 실제 수행 3명분입니다. 연속 구간 비교 4개와 편집 대조군 4개로 총 8개를 구성했습니다. 양팔을 두 번 올렸다 내리는 순서만 평가하며, 새로운 사람 8명이나 독립 촬영 8회가 아닙니다.
추론 전 초안 라벨은 양성 3개·음성 5개였습니다. 동결된 판정기는 8개 모두 reference_contract_not_observable로 unknown을 반환했습니다. 기준 pose의 가시성과 일부 짧은 핵심 구간이 요구한 증거량을 충족하지 못해, 후보가 잘 보이는 경우에도 판정하지 못했습니다.
판정률은 0/8이고, 양성 unknown 3개·음성 unknown 5개입니다. FP와 FN이 0이라는 값은 정확하다는 뜻이 아닙니다. 이 실행에서는 올바른 수행도 위반도 검출하지 못했습니다. 결과를 본 뒤의 수정은 동일 자료의 사후 개발 분석으로 분리하며 독립 검증 점수를 대체하지 않습니다.
| 추론 전 초안 정답 | pass | fail | unknown |
|---|---|---|---|
| 준수 · 3개 | 0 | 0 | 3 |
| 위반 · 5개 | 0 | 0 | 5 |
04 / POST-HOC FAILURE
기준 pose를 관측하지 못한 결과를 본 뒤, 손 높이로 낮음·높음 상태를 정의하는 별도 규칙을 같은 8개 자료에 적용했습니다. 이미 결과를 본 자료의 사후 분석이며 원래 동결 평가를 대체하지 않습니다.
7/8에서 결정을 내렸지만 초안 양성 3개를 모두 틀렸다고 거절했습니다. TP 0·FN 3·TN 4·FP 0이며 음성 1개는 unknown입니다. 판정률 증가를 정확도 개선으로 표현할 수 없습니다. 실제 사람 영상을 자동으로 통과·거절하는 배포 품질은 확보하지 못했습니다.
| 같은 자료의 초안 정답 | pass | fail | unknown |
|---|---|---|---|
| 준수 · 3개 | 0 | 3 | 0 |
| 위반 · 5개 | 0 | 4 | 1 |
05 / PHYSICS IMPLEMENTATION
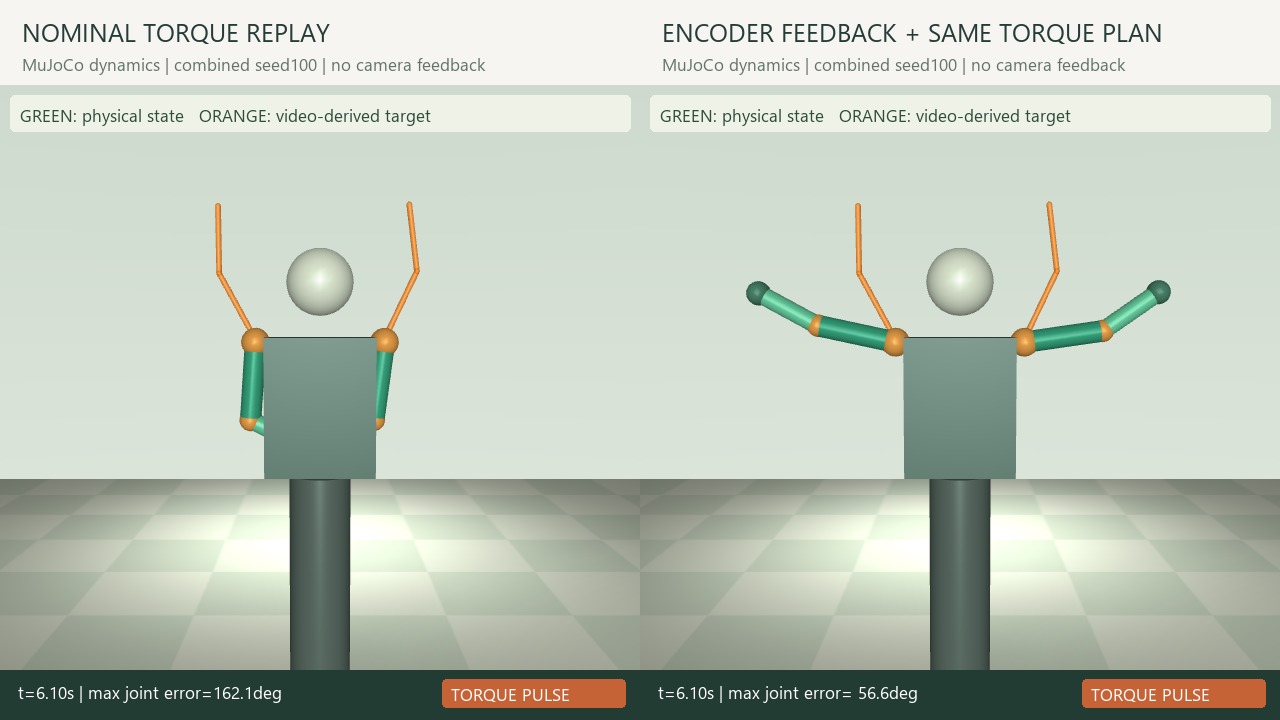
생성 기준 영상의 어깨·팔꿈치 좌표를 영상 평면 각도로 바꾸고, 몸통을 고정한 네 개 hinge 관절에 대응시켰습니다. 평활화한 목표의 위치·속도·가속도로 명목 모델의 역동역학 토크를 미리 계산합니다. 깊이와 축 회전을 복원하는 3D 인체 모션 추정은 아닙니다.
MuJoCo 3.13.0에서 중력·관성·감쇠가 있는 팔을 motor torque로 움직입니다. 실제 관절 상태 q·q̇는 매 물리 스텝에서 전개되며 목표 값으로 덮어쓰지 않습니다. FF+PD는 사전 토크에 encoder 오차 보정을 더하고, 모든 조건에 같은 토크 예산을 적용합니다.
온라인 피드백은 이상적인 시뮬레이터 관절 센서입니다. 영상 pose는 오프라인 목표 생성에만 쓰였으며, 카메라가 로봇을 다시 관측하는 폐루프나 실제 하드웨어를 실행하지 않았습니다.
2D 어깨·팔꿈치 각도
명목 모델의 역동역학
4 hinge · motor torque
같은 이득의 PD 피드백
06 / PAIRED CONTROLLER ABLATION
처음의 open-loop 비교가 약한 기준선임을 확인한 뒤, PD-only를 추가하는 사후 실험을 별도로 설계했습니다. 새 시드 200–219를 보기 전에 조건을 다시 고정하고, 4조건 × 20시드 × 3제어기의 240개 평가를 실행했습니다. 기존 160개 결과는 보존했으며 개발 60개는 평가 수에 포함하지 않았습니다.
PD-only와 FF+PD는 같은 Kp·Kd, 초기 상태, 교란, 모터 제한과 14초 예산을 사용합니다. 차이는 사전 계산 토크의 추가 여부입니다. 제어기별로 각각 최적화한 성능 경쟁이 아니라, 같은 피드백 이득에서 feedforward 항의 기여를 분리한 비교입니다.
복합 조건의 평균 RMSE는 11.656°에서 10.024°로 줄었습니다. 쌍별 감소 평균은 1.632°이며 내부 시뮬레이션 시드 부트스트랩 95% 구간은 1.299–1.964°입니다. 완료 수는 13/20에서 14/20으로 1개 차이이고, 완료율 차이 구간은 0–0.15이므로 완료 성공률이 확실히 높아졌다고 주장하지 않습니다.
| 새 시드의 조건 | PD-only RMSE | FF+PD RMSE | 구간 완료 PD / FF+PD |
|---|---|---|---|
| 명목 모델 + 초기 미세 오차 | 3.11° | 0.66° | 20/20 · 20/20 |
| 외란 토크 | 3.13° | 0.76° | 20/20 · 20/20 |
| 모터 출력 저하 | 4.75° | 2.31° | 20/20 · 20/20 |
| 출력·질량·감쇠 변화 + 외란 | 11.66° | 10.02° | 13/20 · 14/20 |
07 / FAILURE ANALYSIS
원래 시드 100–119의 복합 조건에서 FF+PD는 8/20만 완료했고 평균 RMSE는 13.93°였습니다. 새 시드의 14/20은 다른 표본의 결과이며, 제어기를 개선해 8에서 14로 높였다는 뜻이 아닙니다. 새 평가에서도 6/20은 기준을 충족하지 못했습니다.
완료는 다섯 개 고정 시간창 각각에서 네 관절 오차가 12° 이내인 상태를 0.35초 유지하는 조건입니다. 창 밖의 오차나 춤의 의미·예술성 전체를 보증하지 않습니다. 복구 시간도 허용범위 내 구간의 시작이며, 이미 범위 안인 경우의 약 1ms를 초고속 복구 성능으로 해석하지 않습니다.
독립 점검에서 역동역학 토크의 순동역학 가속도 잔차는 2.84e−14였습니다. 그러나 초기 오차를 없애고 토크 한도를 ±30Nm로 넓힌 진단에서도 open-loop RMSE는 32.10°였습니다. 원래 목표 토크가 12Nm 어깨 제한을 넘는 구간도 있어, 명목 baseline의 큰 오차를 초기 0.25° 오차만의 효과로 설명하지 않습니다.
08 / RESEARCH AND SCOPE
V1의 16편 문헌 검토에 이어 V2는 TCC·LAV의 시간 정렬, FineDiving·CaptainCook4D의 단계·오류 평가, DeepMimic·AMP의 물리 모방 제어와 MuJoCo 공식 문서 등 7개 핵심 근거를 묶었습니다.
이번 구현은 YOLO pose 추론, 직접 작성한 단계 판정, 명목 역동역학과 PD 제어입니다. TCC/LAV의 학습 가중치, DeepMimic/AMP의 강화학습 정책을 재현하거나 새 동작 정책을 학습한 것이 아닙니다.
Physical AI 연결은 영상 관측→목표 변환→물리 행동→관절 피드백까지입니다. 몸통을 고정하고 충돌 접촉을 끈 네 팔 관절만 다뤘으므로 전신 균형·보행·접촉 조작·실제 로봇·sim-to-real 성능을 주장하지 않습니다.
09 / RECORDED EVIDENCE
공개 V2 화면은 실제 영상·저장된 pose·단계 판정과 MuJoCo의 기록된 물리 궤적을 탐색하는 뷰어입니다. Vercel에서 GPU pose 추론이나 물리 제어를 실시간 실행하지 않습니다. 시뮬레이션 영상은 기록된 qpos를 렌더링하지만 평가 당시 상태는 실제 동역학 적분으로 생성했습니다.
기준 영상, 코드·설정 해시, 시드, 교란, 실패와 보류 결과를 함께 남깁니다. 개발에 쓴 자료, 잠근 새 평가, 결과를 본 뒤 추가한 분석을 구분해 열람할 수 있도록 했습니다.
ENGINEERING DECISIONS
Open-loop와의 큰 차이 뒤에 같은 이득의 PD-only를 추가해 사전 토크의 기여를 따로 측정했습니다. 추가 실험의 사후 설계와 새 시드를 기록했습니다.
동결된 실제 영상 8개의 unknown과 사후 수정의 양성 오거절 3개를 함께 남겼습니다. 같은 자료에서 수정한 결과는 새 독립 검증으로 부르지 않습니다.
토크 명령, 실제 관절, 목표 궤적과 외란을 분리해 저장했습니다. 물리 평가 중 목표 자세를 그대로 대입하는 재생을 사용하지 않았습니다.
SCOPE & LIMITS
대한민국 · 한국어 / 영어