 Hyunae Park
개인 PC에서 실행하고 원격으로 유지보수
Gemma 3 27B와 Ollama 기반 로컬 추론을 구성해 교수 개인 PC에 설치했습니다. 설치 이후에도 원격 업데이트를 담당하고 있습니다. 초기 RTX 5090 실행 기록은 교수 PC의 하드웨어 사양과 구분합니다.
개인 PC에서 사용 중 · 원격 유지보수
고려대학교 안암병원 유방암 진료 교수의 개인 PC에서 사용하는 진료 보조 RAG. 2025년 10월 설치 이후 진료·필요 시 사용되며 원격 업데이트를 이어가고 있습니다.
39개 합성 문서 · 184개 청크
Gemini 2.5 Pro judge · 2026.07.29
초기 실행 기록 · 교수 개인 PC 사양과 구분
01 / INSTALLATION & USE
2025년 10월, 고려대학교 안암병원에서 유방암 진료를 담당하는 교수의 개인 PC에 설치했습니다. 교수는 진료 중이나 필요할 때 사용하고 있으며, 설치 이후에도 제가 원격으로 중간중간 업데이트하고 있습니다.
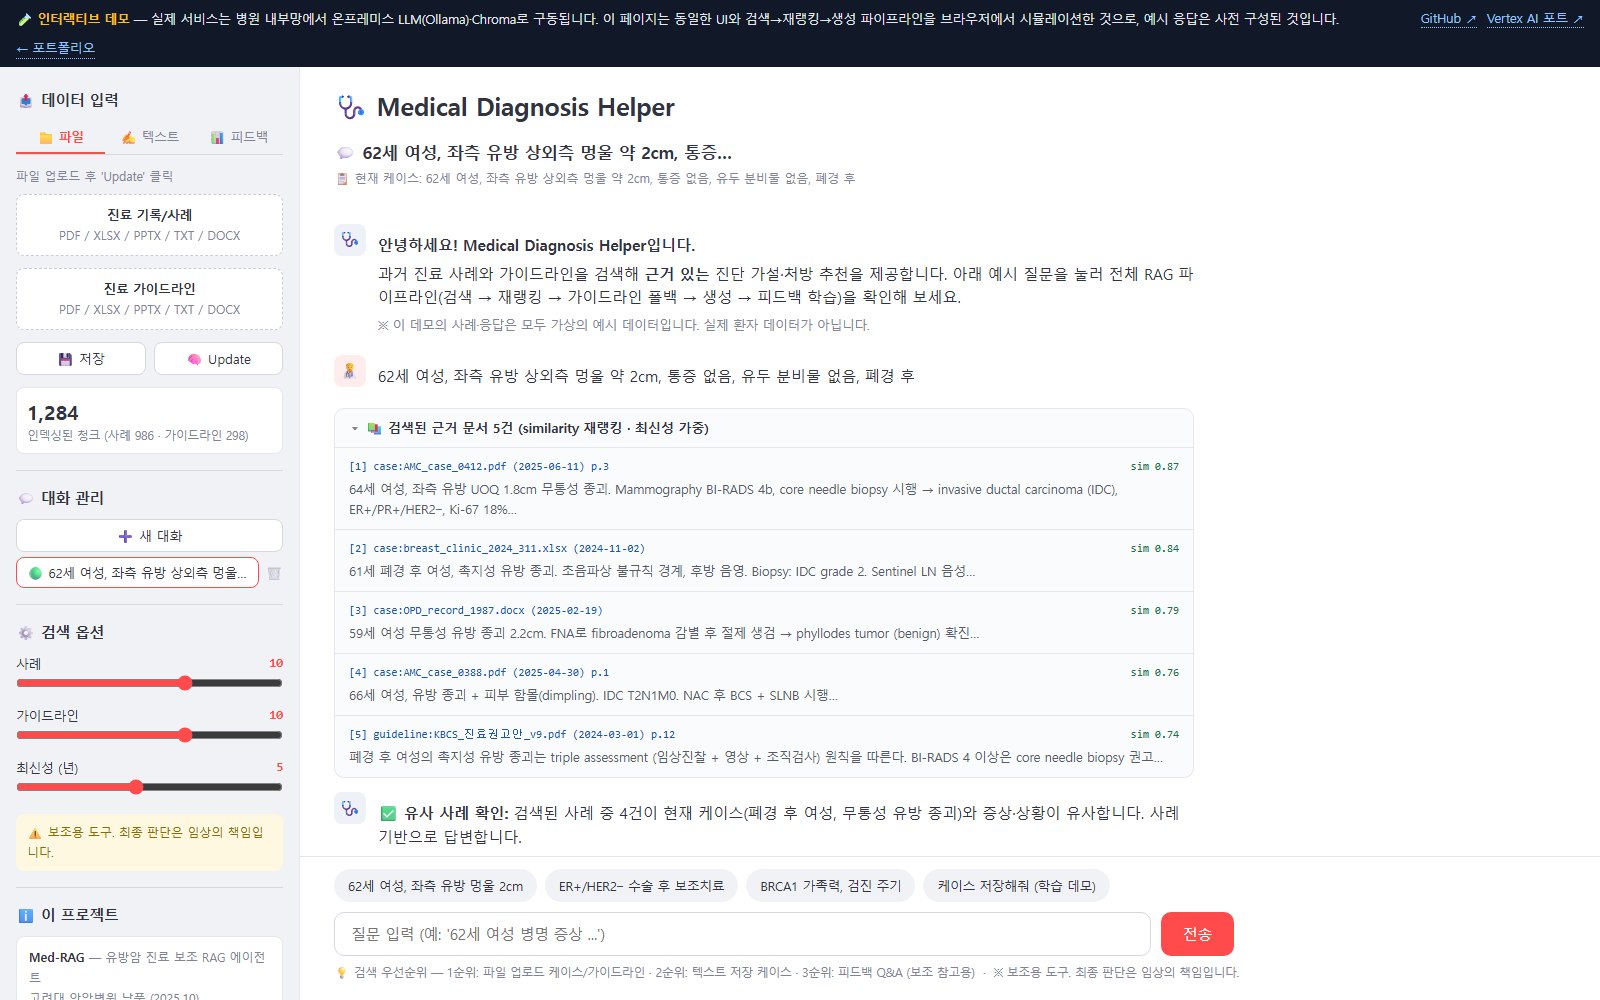
증례와 가이드라인을 검색하고 답변의 근거 문서를 확인하는 구조입니다. 납품판 코드와 자료는 비공개이며, 공개한 성능 수치는 별도로 만든 Vertex 포트와 합성 데이터 실험의 결과입니다.
02 / USE & EXPERIMENTS
현재 사용·지원 현황은 2026.09.15 프로젝트 담당자가 제공한 내용입니다. 설치 범위는 교수 개인 PC이며, 원격 업데이트로 사용을 지원합니다. 공개 실험에서는 검색·답변 품질과 튜닝 선택을 별도로 검증했습니다.
| 단계 | 환경 | 사용·지원 또는 검증 범위 |
|---|---|---|
| 설치 · 2025.10 | 교수 개인 PC · 로컬 추론 | 진료 중·필요 시 사용 · 이후 원격 업데이트 |
| 공개 RAG 평가 | Vertex AI / ADK · Gemini 2.5 Flash | 합성 문서 39개 · 질문 24개 · 코드와 평가 보고서 |
| 튜닝 비교 | Qwen2.5-7B · QLoRA · RTX 4090 | 학습 154개 · 검증 30개 · Base / v1 / v2 비교 |
03 / SYSTEM
증례를 먼저 찾고 가이드라인으로 보완합니다. 같은 나이와 성별만으로 같은 증례라고 판단하지 않도록 조건을 두고, 근거가 약할 때 불확실성을 드러내게 했습니다. 공개 Vertex 포트에서는 검색·초안과 검토를 두 단계 에이전트로 구성했습니다.
증례 · 필요한 근거
Chroma · 증례 / 가이드라인
근거를 포함한 답변
근거 · 불확실성 확인
04 / EVIDENCE
기존 평가자는 실제 검색 문서를 보지 못했습니다. 문서를 전달한 뒤 답변 평가가 24/24에서 20/24로 바뀌었고, 존재하지 않는 인용과 근거 없는 설명을 발견했습니다.
검색 성공과 답변 품질을 나눠 평가했습니다. 정답 문서를 찾는 것만으로 근거 있는 답변이 보장되지는 않았습니다.
| 검증 항목 | 결과 | 조건 |
|---|---|---|
| 정답 문서 검색 | 23/24 | 파일명 기준 객관 평가 |
| 답변 평가 통과 | 20/24 | 검색 문서를 보는 LLM judge |
| 근거성 | 4.42 / 5 | 24개 합성 질문 |
| 응답 시간 p50 / p95 | 35.98s / 52.99s | 2단계 에이전트 전체 · n=24 |
| 요청당 비용 | $0.006542 | 생성 + 임베딩 추정 · judge 제외 |
05 / FAILURE ANALYSIS
q14는 정답 문서를 찾았지만, 평가에 제공된 근거에 없는 인용문으로 실패 판정을 받았습니다. 평가 보고서에서 실패한 q06·q14·q22·q23은 모두 정답 문서를 검색한 사례였습니다. 검색 recall만 보고 통과시키면 이 오류를 놓칩니다.
반대로 q08은 정답 문서를 찾지 못했지만 적절한 답변 유보로 judge 평가를 통과했습니다. 검색 누락, 잘못된 근거 주장, 적절한 유보를 서로 다른 결과로 기록해야 한다는 판단으로 이어졌습니다.
정답 파일명과 대조
검색 문서 텍스트 포함
주장 · 인용 · 유보 구분
문항별 판정 사유 확인
06 / ITERATION
Qwen2.5-7B를 154개 예제로 QLoRA 학습했습니다. 위조 인용은 2건에서 0건으로 줄었지만, 답할 수 있는 질문까지 거부하는 문제가 생겼습니다.
거부 예제 37개 중 8개(약 22%)에 잘못된 라벨이 있었습니다. 이를 수정한 v2에서 근거성과 유용성이 회복됐지만 기본 모델은 넘지 못했습니다. 22%의 분모는 전체 학습셋이 아닌 거부 예제입니다.
이 비교에서는 기본 모델에 엄격한 프롬프트와 검토 단계를 결합하는 구성을 권장했습니다. 공개 실험의 모델 선택 결론이며 병원 납품판의 모델을 교체했다는 의미는 아닙니다.
| 모델 | 위조 인용 | 근거성 / 유용성 |
|---|---|---|
| Base | 2 | 4.80 / 4.63 |
| QLoRA v1 | 0 | 4.40 / 4.13 |
| QLoRA v2 | 0 | 4.63 / 4.30 |
07 / SERVING LAB
품질 gate, 모델·데이터 버전 고정, 스트리밍 지연 측정과 수동 롤백 절차를 공개 코드로 구현했습니다. CPU 테스트 31개와 실제 로컬 HTTP 시나리오 계약 14개를 확인했습니다. 정상 fixture 통과, 결함 후보 및 변조된 요약의 release 차단을 실행 기록 탐색 페이지에서 확인할 수 있습니다.
GPU 성능과 복구 시간은 아직 측정하지 않았습니다. 현재 운영 중인 RTX 4090 회의 서비스와 분리된 환경에서 측정한 뒤 결과를 추가합니다.
코드 · 모델 · 데이터
인용 오류 · 과잉 거부
지연 · 큐 · GPU
이전 artifact
ENGINEERING DECISIONS
Gemma 3 27B와 Ollama 기반 로컬 추론을 구성해 교수 개인 PC에 설치했습니다. 설치 이후에도 원격 업데이트를 담당하고 있습니다. 초기 RTX 5090 실행 기록은 교수 PC의 하드웨어 사양과 구분합니다.
질문과 답변만 평가하면 그럴듯한 설명이 높은 점수를 받았습니다. 검색된 문서를 함께 전달해 실제 근거성을 검사했습니다.
QLoRA는 위조 인용을 줄였지만 과잉 거부를 늘렸습니다. 라벨을 고쳐도 기본 모델이 전반적인 judge 점수에서 앞서, 기본 모델과 엄격한 프롬프트를 권장했습니다.
SCOPE & LIMITS
대한민국 · 한국어 / 영어