추론과 결과 탐색 분리
GPU 추론은 로컬에서 실행하고 프레임별 출력과 실행 조건을 저장합니다. 브라우저에서는 모델을 다시 실행하지 않고 같은 시점의 입력과 결과를 비교합니다.
AI · 컴퓨터 비전 실험 모음
공개 비전 모델의 추론을 연결하고 평가·시각화를 구현했습니다. 18개 기술 페이지에서 객체 관계, 동작 비교, 물리 제어, 추적·자세 추정·모션 캡처·이상 탐지의 실행 결과와 오류를 살펴보고, 실행한 단계와 모델 공개·접근·파일 준비가 필요한 단계를 구분합니다.
실제 실행 결과 · 단계별 진행 · 모델 준비 상태
하나의 생성 영상 · 기본·개선 실행 비교
한 기준 동작·4관절 모형의 내부 반복
01 / EXPERIMENT MAP
기존 5개 실험에 13개 기술 페이지를 추가했습니다. 18개는 페이지 수이며, 18개 모델의 전체 파이프라인 실행 성공을 뜻하지 않습니다. 결과가 있는 페이지에서는 입력과 원시 예측을 비교하고, 준비 중인 페이지에는 완료 단계와 필요한 모델 공개·접근·파일을 기록합니다. 관계 인식과 동작·제어의 상세 설계는 기존 사례로 연결합니다.
| 실험 | 살펴보는 것 | 실행 범위 |
|---|---|---|
| RelateAnything | 객체 연결 전후의 관계 점수와 오류 | 생성 영상 481프레임 |
| MotionCheck V1 | 2D 관절과 시간 정렬로 동작 차이 비교 | 기준·수행 영상과 오류 사례 |
| MotionCheck V2 | 동작 단계 판정과 MuJoCo 팔의 토크 제어 | 내부 시뮬레이션 400회 |
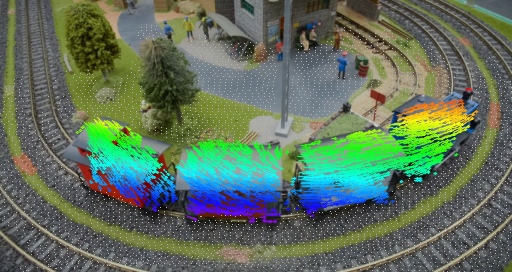
| TraceAnything | 영상 위 궤적과 3D 점군 | 기차 80·춤 90프레임과 입력 변형 |
| DeepLabCut | 사람·생쥐의 2D 키포인트와 사람의 3D 포즈 추정 | 춤 90프레임·17관절, 생쥐 120프레임·27점 |
| TAPNext++ | 영상 속 표면 점의 2D 궤적 | 춤 90·기차 80프레임 실제 추론 |
| Sapiens2 | 308개 키포인트와 신체·의복 영역 분할 | 춤 90프레임, pose·segmentation 각각 실행 |
| HTD-Refine | PVA-Net의 관절 위치·속도·가속도 추정 | 90프레임 PVA-Net 실행 · 최종 메시 보정 대기 |
| ReViV | 1인칭 영상의 몸·양손·카메라·시선·상대 깊이 추정 | 공식 2초 예제 · 256 모델의 16입력 프레임 → 60모션 프레임 |
| 4DAnyone | 사람 영상에서 새로운 시점의 영상 생성 | 공개 가중치 준비 · SMPLX_NEUTRAL.npz 파일 필요 |
| SAM 3.1 | 텍스트로 지정한 대상의 마스크·ID 추적 | 코드·환경 준비 · 모델 접근 승인 대기 |
| Fast SAM 3D Body | 이미지별 인체 메시 추정 가속 | 모델 API import 확인 · 가중치 접근 승인 대기 |
| CARI4D | 사람과 물체의 3D 동작·상호작용 복원 | 코드·환경 준비 · SMPL-H 모델 파일 필요 |
| Dense4D | 몸·옷·머리카락의 밀집 4D 표면 대응 | 공식 데모 연결 · 코드·가중치 공개 대기 · 자체 추론 미실행 |
| S4VY | 시공간에 걸친 물체 영역 분할과 ID 연결 | 춤 90프레임의 기존 분할·점 추적 비교와 입력점 준비 · S4VY 코드 공개 승인 대기 |
| PatchCore | 정상 오렌지와의 외관 차이·이상 히트맵·놓친 사례 | 사진 248장 평가 · 실제 선별 라인 247프레임 검출·추적 연동 |
| SOMA | 인물별 골격 자세에 따른 피부·근육 변형 | 공식 자료 조사 · SKIM v2 데이터·가중치 접근 미승인 · 자체 추론 미실행 |
| MoCapAnything V2 | 참조 골격을 사용하는 관절 위치·회전 추정과 BVH 내보내기 | 재규어 렌더링 34프레임·북극곰 wild sample 103프레임 실제 추론 |
02 / MY CONTRIBUTION
구현에서는 객체 연결·시간 후처리, 관절 비교·단계 판정, MuJoCo 토크 제어를 구성했습니다. TraceAnything 추론은 Windows와 24GB GPU에 맞춰 실행 순서와 attention 호환 처리를 조정하고, 내보낸 좌표가 원시 예측과 일치하는지 확인했습니다.
평가에서는 관측 누락과 관계 오분류, 자세 차이와 시간 차이, 제어 오차와 완료 여부를 구분했습니다. DeepLabCut은 기본 설정과 대상 박스 선택 조건을 비교하고, 예측 신뢰도와 실제 정확도를 구분해 기록했습니다. 추가 모델은 실행한 단계·내보낸 데이터·남은 조건을 기록하고, 실제 결과와 준비 상태를 같은 Vercel 사이트의 18개 기술 페이지로 연결했습니다.
03 / 2D POINT TRACKING
공식 공개 가중치로 춤 90프레임과 기차 80프레임의 2D 점 추적을 실행했습니다. 원본 영상 위 궤적과 프레임별 예측을 함께 제공해 같은 점이 어디로 이동하는지, 어느 구간에서 표면을 벗어나는지 확인할 수 있습니다.
결과는 영상 픽셀 좌표의 점 궤적입니다. 인체 관절 이름이나 세계 좌표의 3D 이동을 추정한 결과가 아니며, 가림·빠른 회전에서의 오류와 정답 대비 정확도는 별도 검증이 필요합니다.
04 / POSE AND SEGMENTATION
같은 춤 90프레임에 Sapiens2-0.4B의 pose와 segmentation을 각각 실행했습니다. 308개 키포인트와 배경을 포함한 29개 신체·의복 분할 클래스의 결과를 원본과 비교합니다. 모델 가중치는 로컬에 두고 영상, 원시 예측, 실행 조건을 내보냈습니다.
Pose는 프레임마다 가장 큰 사람 검출 박스를 선택하고, segmentation은 프레임별로 영역을 분할합니다. 시간에 걸친 사람 ID나 마스크 일관성을 보장하지 않습니다. 관절 점수는 1을 넘을 수 있는 원시 heatmap 값이며, 확률·정확도로 표시하지 않았습니다. 내보낸 90프레임과 원시 데이터의 일치를 확인했습니다.
05 / PARTIAL PIPELINE
HTD-Refine의 PVA-Net 단계에서 공식 운동 예제 90프레임의 관절 위치·속도·가속도를 추정했습니다. 이 단계의 실제 출력과 입력을 공개하고, 전체 파이프라인에서 어디까지 실행했는지 구분했습니다.
최종 인체 메시 보정은 실행하지 않았습니다. 별도 SMPLX_NEUTRAL.npz 모델 파일이 필요하며, PVA-Net 결과를 완성된 3D 모션 보정이나 메시 복원으로 표현하지 않습니다.
06 / EGOCENTRIC MOTION
공식 2초 RGB 예제에 256×256 reviv_500b 모델을 실행해 몸, 양손, 카메라, 시선과 상대 깊이를 추정했습니다. 원본 32프레임·16fps에서 16프레임·8fps를 입력으로 선택했고, 몸·손·카메라·시선은 60프레임·30fps로 출력됩니다. 상대 깊이는 16프레임·8fps 출력입니다. 뷰어에서는 원본과 깊이 프레임을 반복해 같은 시간축으로 비교합니다.
몸·카메라 3D 뷰는 예측 좌표계를 그대로 사용했습니다. 양손의 화면 재투영에만 공식 예제의 정답 카메라 내부 파라미터 K를 사용했고, 모델 추론 입력에는 넣지 않았습니다. 특히 첫 프레임의 손 위치가 영상과 크게 어긋나는 결과를 수동 수정 없이 보존했습니다.
단일 공식 예제의 실행·출력 형식을 확인한 실험이며, 정답 관절·시선과 정확도를 비교하지 않았습니다. 회색조 상대 깊이는 실제 미터 단위 거리로 검증하지 않았습니다. Cosmos 1.0 접근 동의가 필요한 512×512 metric_depth 모델은 실행하지 않았습니다.
07 / KEYPOINT ESTIMATION
SuperAnimalHumanBody의 RTMPose-x로 춤 영상 90프레임의 17관절을, SuperAnimalTopViewMouse의 HRNet-w32로 생쥐 영상 120프레임의 27개 키포인트를 추론했습니다. 원본과 예측 영상을 같은 프레임으로 비교하고, 실행 조건·신뢰도·예측 데이터를 함께 제공합니다.
여러 사람이 있는 춤 영상의 기본 설정에서 대상 인물이 바뀌는 오류를 확인했습니다. 프레임마다 가장 큰 검출 박스를 선택하는 조건을 추가해 비교했습니다. 이 규칙은 사람의 신원을 연결하는 추적기가 아니며, 같은 인물이 계속 선택되거나 관절 위치가 정확하다는 보장은 없습니다.
같은 춤 90프레임에 FMPose3D 0.0.10의 공식 연동으로 H36M 17관절의 3D 추정을 실행했습니다. 별도 YOLOv3·HRNet-w48 입력을 사용하며, 기본·최대 박스 선택의 예측과 회전 영상을 비교합니다. 골반 기준 상대 좌표이고, 최대 박스 선택에서도 60프레임 부근의 관절 오배치가 남아 있습니다.
08 / 3D TRACKING
TraceAnything으로 DAVIS 기차 80프레임과 춤 90프레임을 추론했습니다. 춤은 전체 90프레임, 3프레임마다 선택한 30프레임, 인물 주변을 고정 크롭한 30프레임을 비교합니다. 원영상 위 투영과 회전 가능한 3D 뷰를 함께 제공합니다.
DAVIS 마스크는 표시할 대상, 고정 크롭과 카메라 정합 가중치에 사용했습니다. 마스크가 예측된 3D 좌표를 교정하지는 않습니다. 빠른 회전과 가림에서 점이 몸 표면을 벗어나는 오차가 남아 있어 현재 품질 검토 중입니다.
09 / ANOMALY DETECTION
PatchCore를 별도 PyTorch 구현으로 연결해 정상 오렌지 사진 110장의 특징 메모리 뱅크를 만들고, 별도 정상 30장으로 임계값을 고정했습니다. 평가 사진 248장의 원본·이상 히트맵·점수와 놓친 사례를 공개합니다. 불량 198장 중 12장만 검출해 재현율은 6.06%였고, 정상 50장에서는 오탐이 없었습니다. 낮은 검출 성능을 그대로 남긴 탐색 실험입니다.
실제 Pexels 선별 라인 영상 247프레임에는 RF-DETR Small 검출, ByteTrack 추적, PatchCore 이상 점수와 연속 프레임 판정을 연결했습니다. 저장된 원본·오버레이와 추적 기록을 비교할 수 있습니다. 이 영상은 사진과 촬영 조건이 다르고 품질 정답이 없어, 파이프라인 연동 확인 범위로 기록했습니다.
10 / MOTION CAPTURE
저자가 공개한 clean reimplementation과 가중치로 Jaguar-Run 렌더링 예제 34프레임·30fps의 39관절과 북극곰 wild sample 배경 제거본 103프레임·15fps의 34관절을 추론했습니다. 단안 영상과 참조 자산의 단일 참조 프레임·골격 정보를 입력해 관절 위치와 회전을 얻고, 예측 회전을 BVH 파일로 내보냈습니다.
입력 영상과 회전 가능한 3D 관절을 같은 프레임으로 비교하고, 직접 예측한 관절 위치와 내보낸 BVH를 다시 읽어 계산한 FK 관절 위치를 전환해 살펴볼 수 있습니다. 원시 좌표·영상·BVH와 실행 조건을 함께 제공합니다. 두 공개 예제의 실행 검증이며 논문 벤치마크 재현은 아닙니다. 북극곰 영상에는 정답 관절이 없어 정확도를 계산하지 않았습니다.
ENGINEERING DECISIONS
GPU 추론은 로컬에서 실행하고 프레임별 출력과 실행 조건을 저장합니다. 브라우저에서는 모델을 다시 실행하지 않고 같은 시점의 입력과 결과를 비교합니다.
마스크 선택이나 보기 좋은 시각화를 정확도 개선으로 표현하지 않습니다. 원시 출력과 처리 조건을 남겨 결과를 다시 확인할 수 있게 합니다.
SCOPE & LIMITS